Les limites de l'IA générative à connaître avant de lui faire confiance
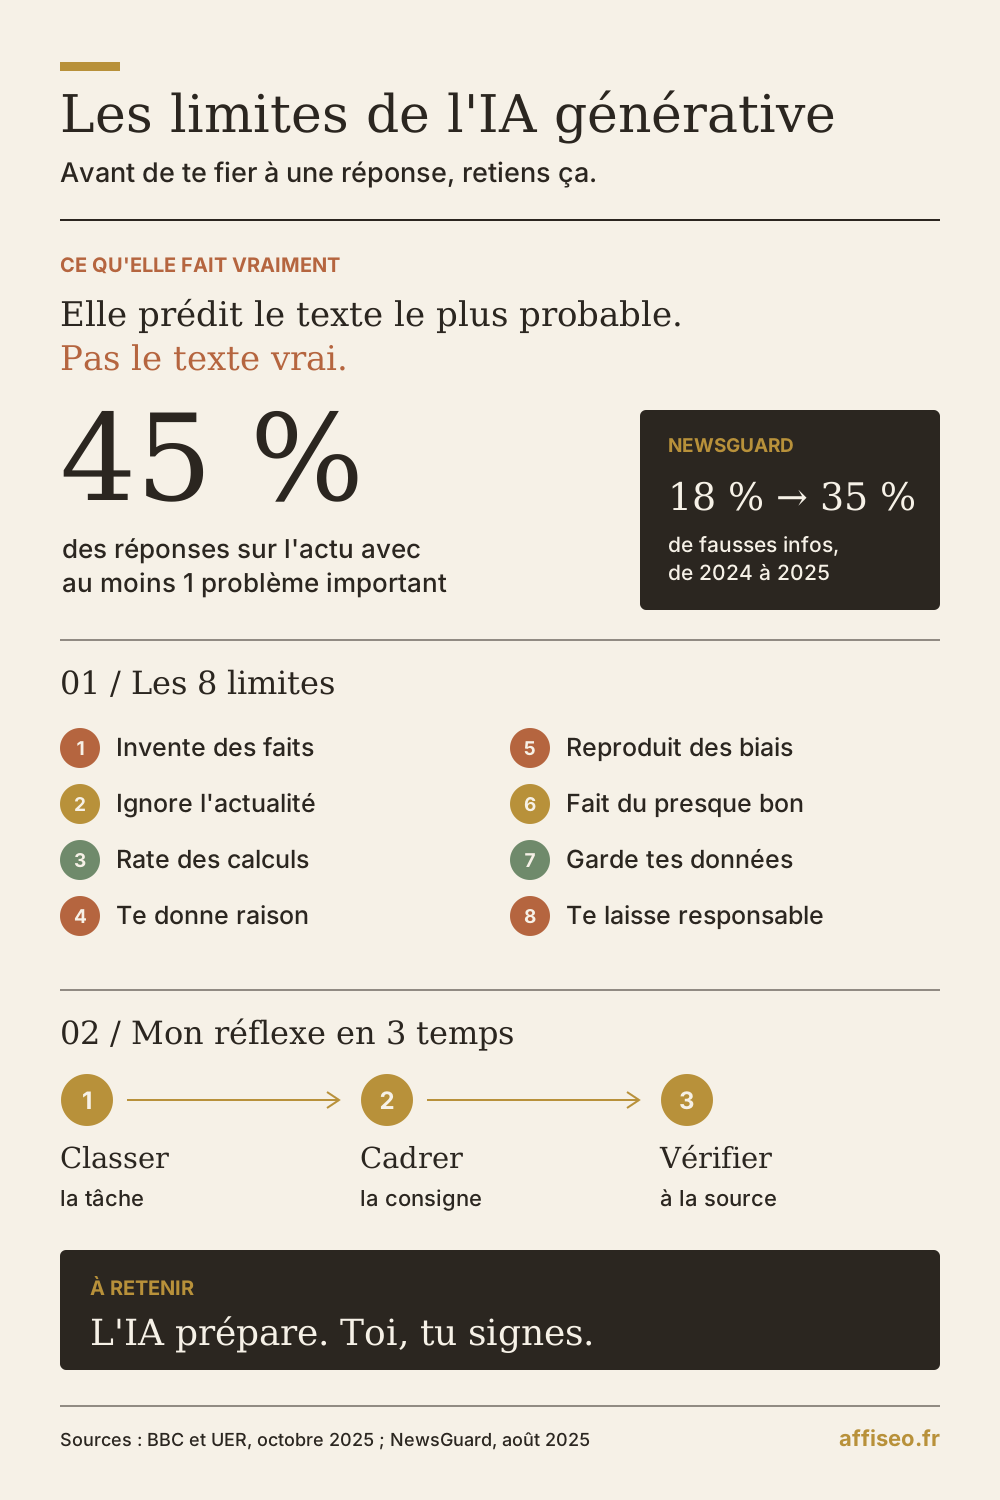
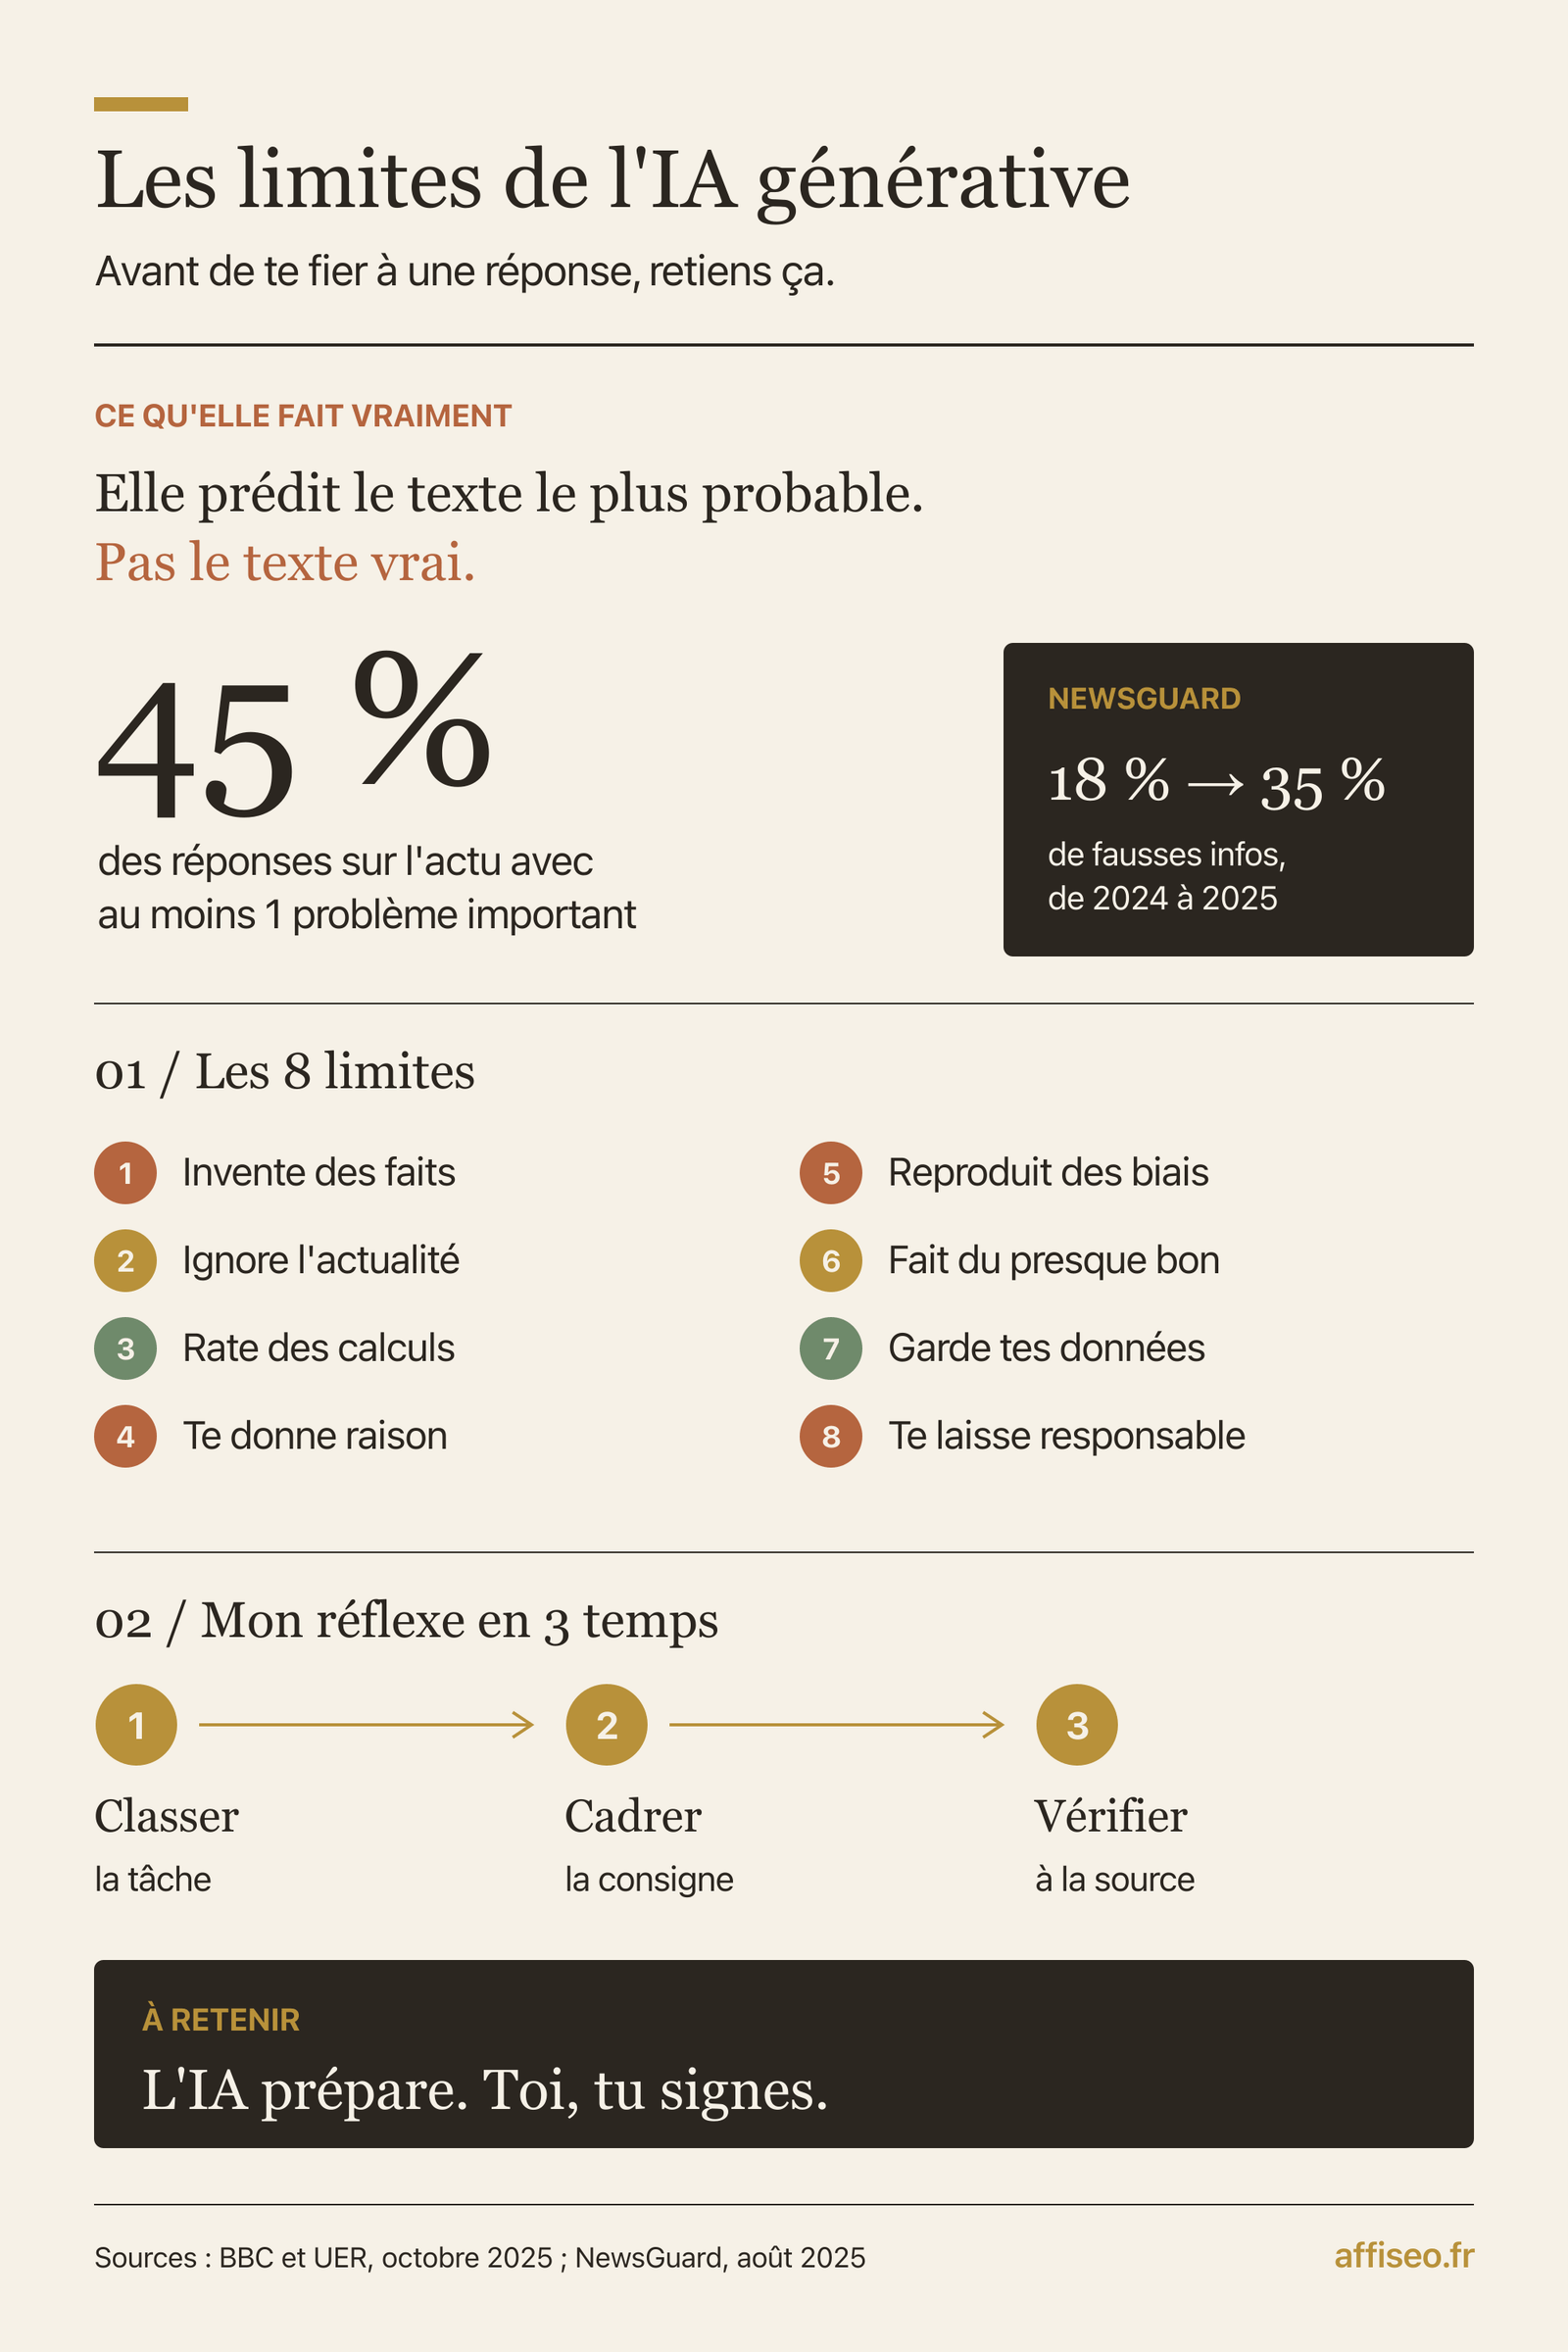
- L'IA générative calcule la suite de texte la plus probable : elle ne sait pas ce qui est vrai.
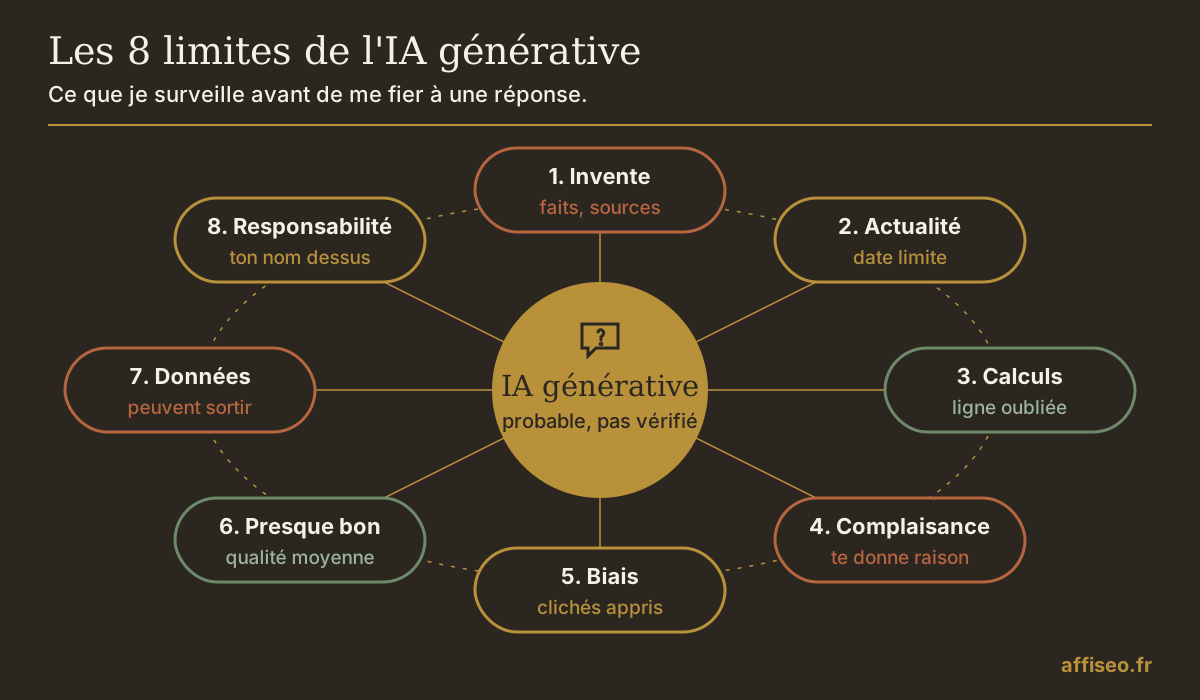
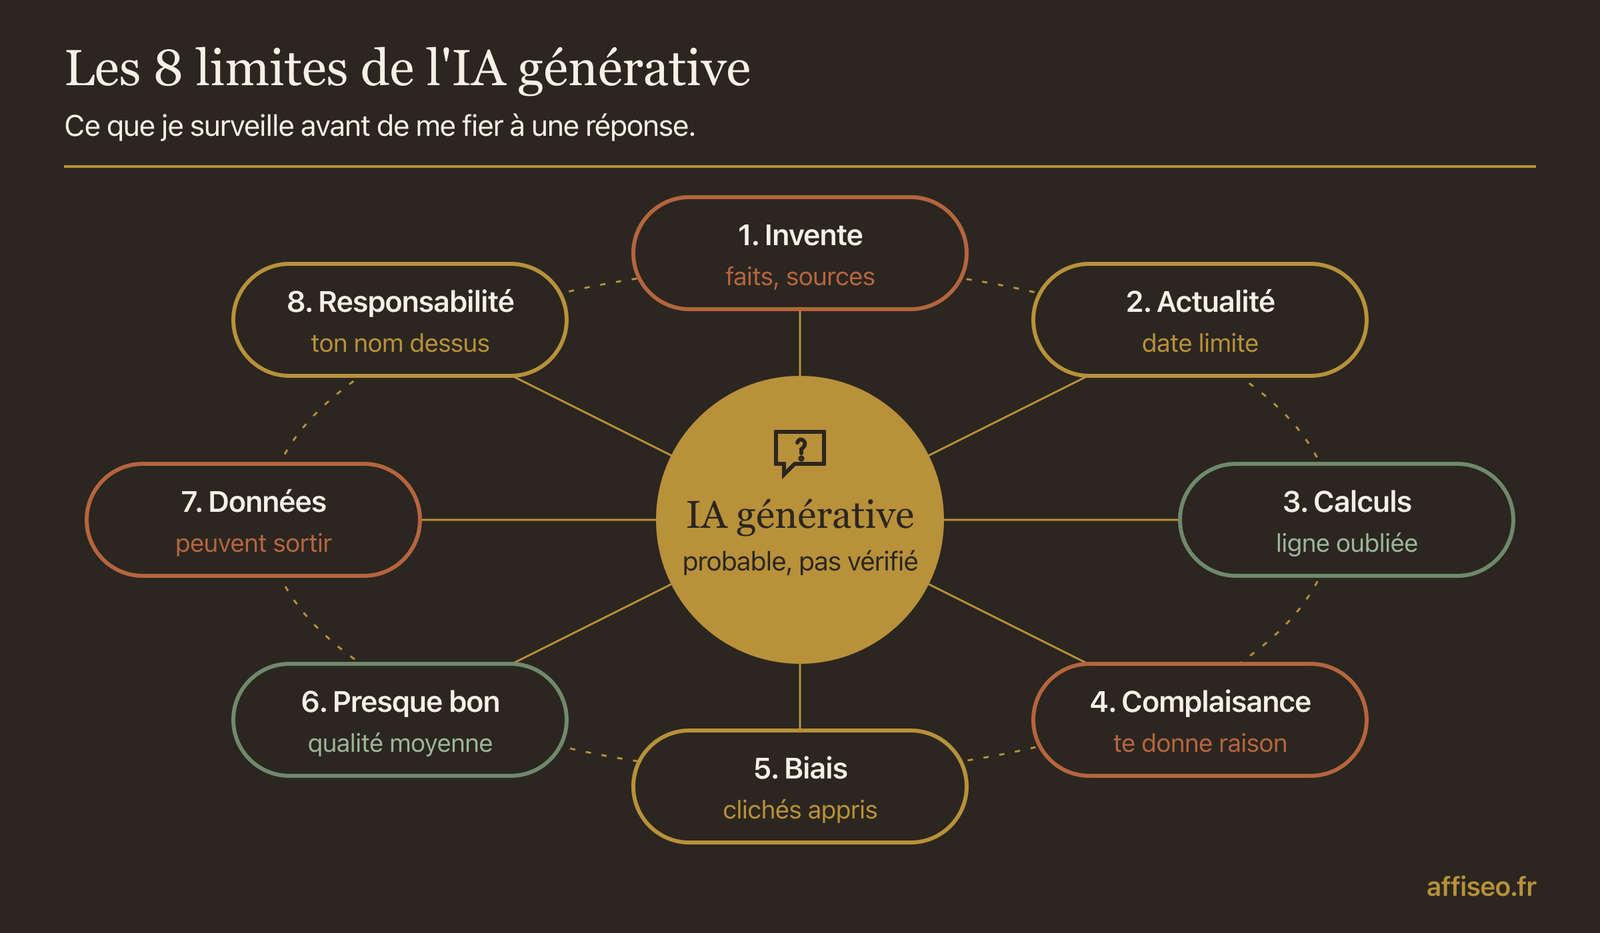
- Ses 8 limites : faits inventés, actualité, calculs, complaisance, biais, qualité moyenne, données confiées, responsabilité.
- La recherche web l'aide sur l'actu sans tout régler : elle répond plus souvent, et se trompe plus souvent.
- Je m'en sers tous les jours pour produire vite ; tout ce qui touche à un chiffre, une règle ou un client se vérifie à la source.
Non, tu ne peux pas te fier à une IA générative comme à une source : elle produit la réponse la plus probable, pas la réponse vérifiée. Elle invente parfois des faits, ignore ce qui s'est passé après sa date limite, se plante sur des calculs simples, reproduit des biais et a tendance à te donner raison. Moi je m'en sers tous les jours pour aller vite, et je ne prends jamais une de ses réponses pour une preuve.
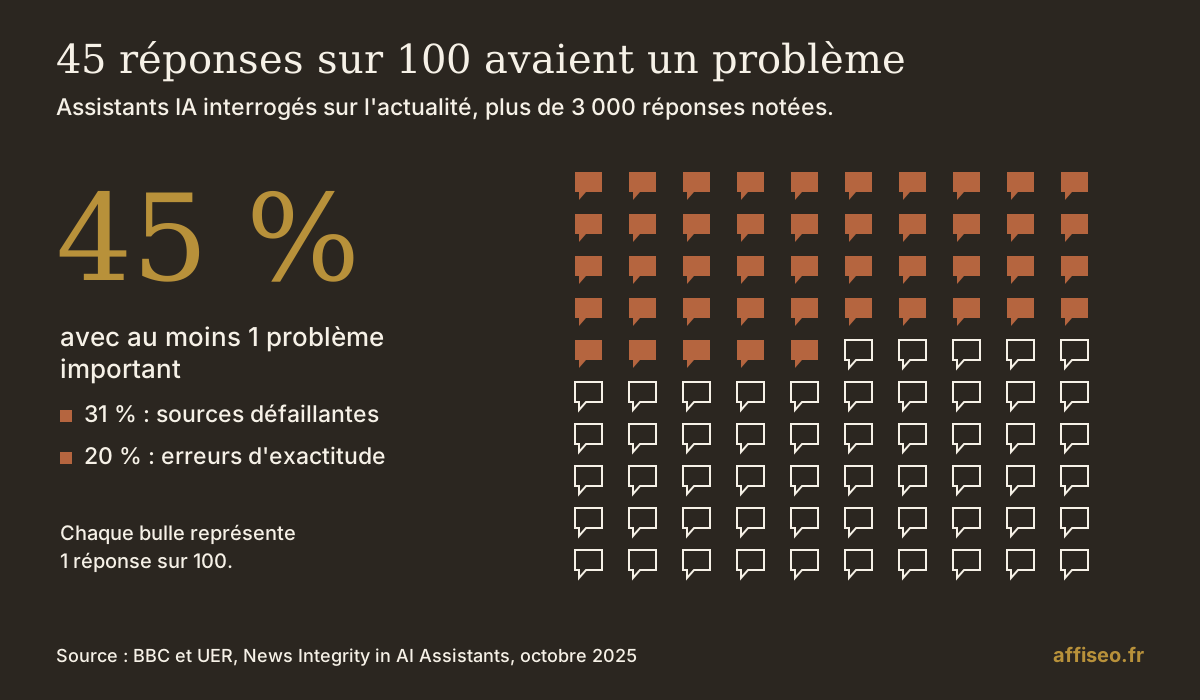
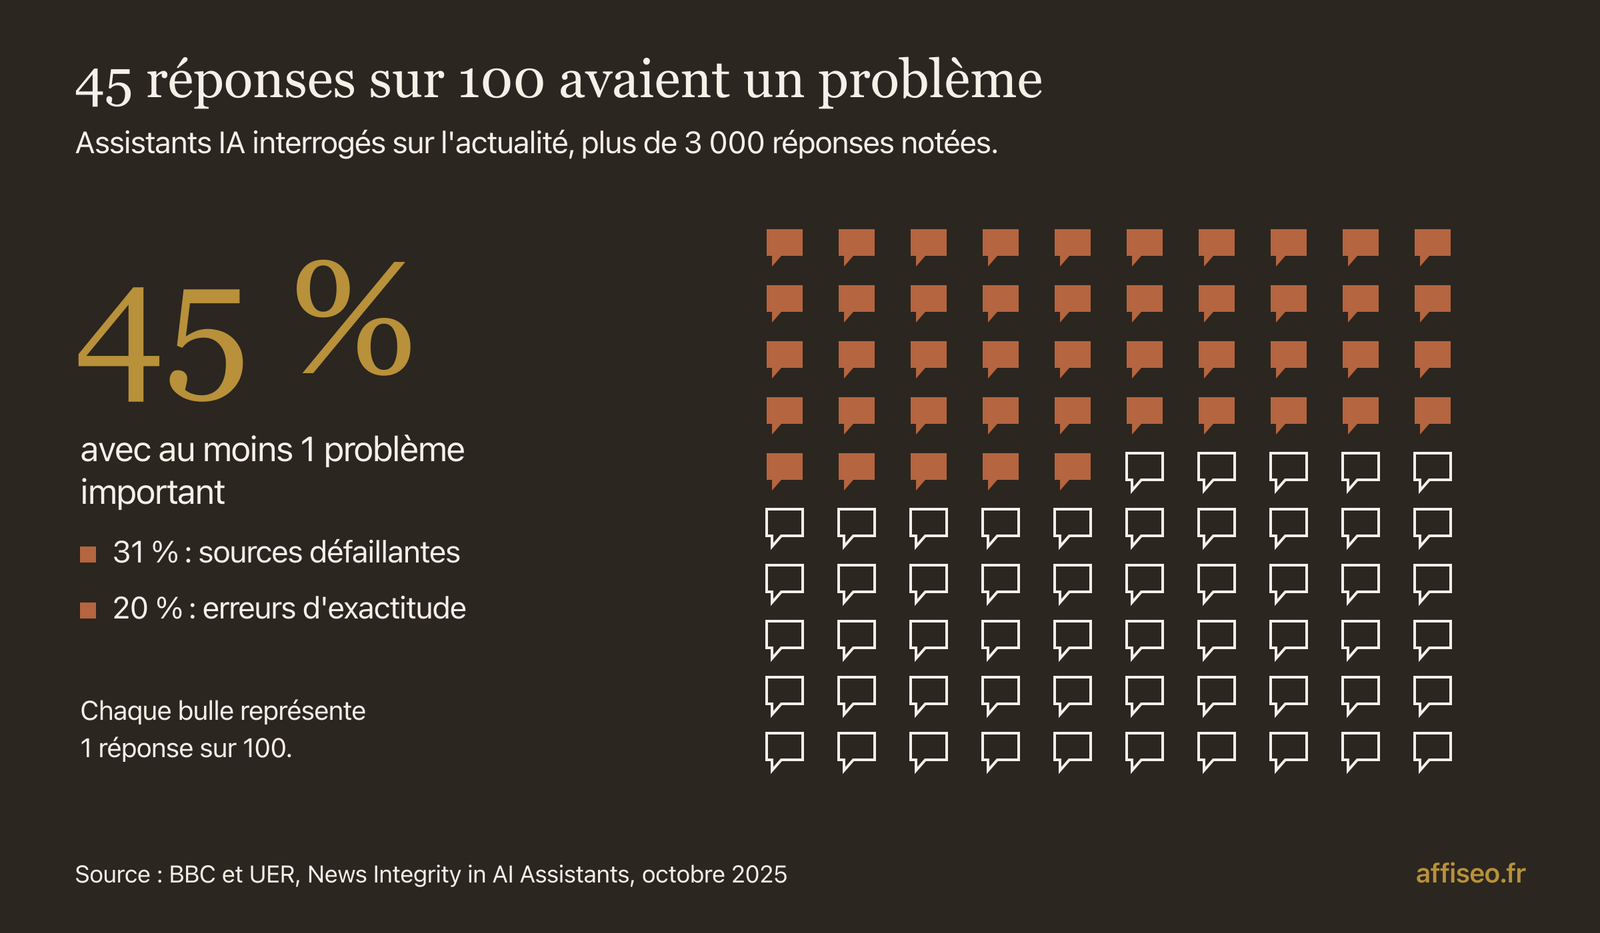
Le truc c'est que ces erreurs ne ressemblent pas à des erreurs. Le texte est fluide, sûr de lui, bien rangé. Dans une étude menée par la BBC et l'UER (l'union des radios et télévisions publiques européennes) sur plus de 3 000 réponses à des questions d'actualité, 45 % avaient au moins un problème important. Ça ne veut pas dire que l'outil est nul. Ça veut dire qu'il faut savoir où il casse.
Je te liste ici les 8 limites que je garde en tête, avec pour chacune le réflexe qui évite la casse. Si tu découvres le sujet, commence par mes repères sur l'IA générative, puis reviens ici avec un projet concret en tête.
Tu en es où ?
Pourquoi l'IA générative se trompe avec autant d'assurance
ChatGPT, Claude ou Gemini reposent sur un grand modèle de langage : un programme entraîné sur d'énormes quantités de texte pour prédire la suite la plus probable. La CNIL le dit très bien, ces systèmes sortent le résultat le plus probable au regard de leurs données d'entraînement. Probable, pas vrai. Quand l'information manque, le modèle complète quand même, et le résultat peut paraître parfaitement crédible.
Un article de recherche publié en 2025, Why Language Models Hallucinate, donne une explication que je trouve très parlante. Les modèles sont entraînés et notés un peu comme des élèves devant un QCM : répondre au hasard rapporte parfois des points, avouer « je ne sais pas » n'en rapporte jamais. Du coup ils apprennent à deviner plutôt qu'à douter.
Dans Thinking, Fast and Slow, Daniel Kahneman montre qu'une réponse qui vient facilement ne déclenche aucun contrôle, et qu'un message facile à lire nous semble plus vrai. Son exemple de la batte et de la balle est parfait : les 2 coûtent 1,10 dollar ensemble, la batte coûte 1 dollar de plus que la balle, et beaucoup de gens répondent 10 centimes pour la balle alors que c'est 5. La réponse rapide sonne juste, donc on ne la vérifie pas. Une réponse d'IA bien tournée déclenche exactement ce réflexe.
J'ai découvert l'IA avant la sortie de GPT 3.5, avec un outil de rédaction très bancal. Aujourd'hui les modèles sont bluffants, et c'est justement là que ça se complique : plus le texte est propre, moins tu as envie de le contrôler. Le schéma ci-dessous te donne les 8 limites d'un coup d'œil, je les reprends une par une juste après.
Elle invente des faits, des sources et des chiffres
C'est ce qu'on appelle une hallucination : une réponse fausse présentée comme vraie. Un chiffre qui n'existe pas, une étude jamais publiée, un lien qui mène nulle part, une citation prêtée à la mauvaise personne. Et ça arrive même quand l'outil a accès au web.
L'étude BBC et UER, publiée le 22 octobre 2025, l'a mesuré sur ChatGPT, Copilot, Gemini et Perplexity, avec 22 médias publics, 18 pays et 14 langues. Résultat : 45 % des réponses avaient au moins un problème important, 31 % un vrai souci de sources (absente, trompeuse ou fausse) et 20 % une erreur d'exactitude majeure, détails inventés et infos périmées compris.
En entreprise, ça se paie. En février 2024, un tribunal canadien a condamné Air Canada à verser au total 812 dollars canadiens à un client, différence de tarif, intérêts et frais compris. L'assistant du site lui avait affirmé qu'il pouvait demander après son voyage un tarif réduit lié à un décès, ce qui était faux. La compagnie a plaidé que l'assistant était responsable de ses propres réponses. Le tribunal a balayé l'argument.
Les hallucinations méritent un guide à elles seules : dans la page dédiée, je te montre comment vérifier ce qu'une IA te répond, phrase par phrase.
Elle ignore l'actualité, et la recherche web ne règle pas tout
Chaque modèle a une date limite des connaissances : le moment où ses données d'entraînement s'arrêtent. Après, il ne sait rien, sauf si l'outil va chercher sur internet. Par exemple, la documentation d'Anthropic indique une date limite fiable à juin 2026 pour ses modèles Claude les plus récents. Un prix, un taux ou une règle qui a bougé depuis, il peut te servir l'ancienne version sans le moindre doute.
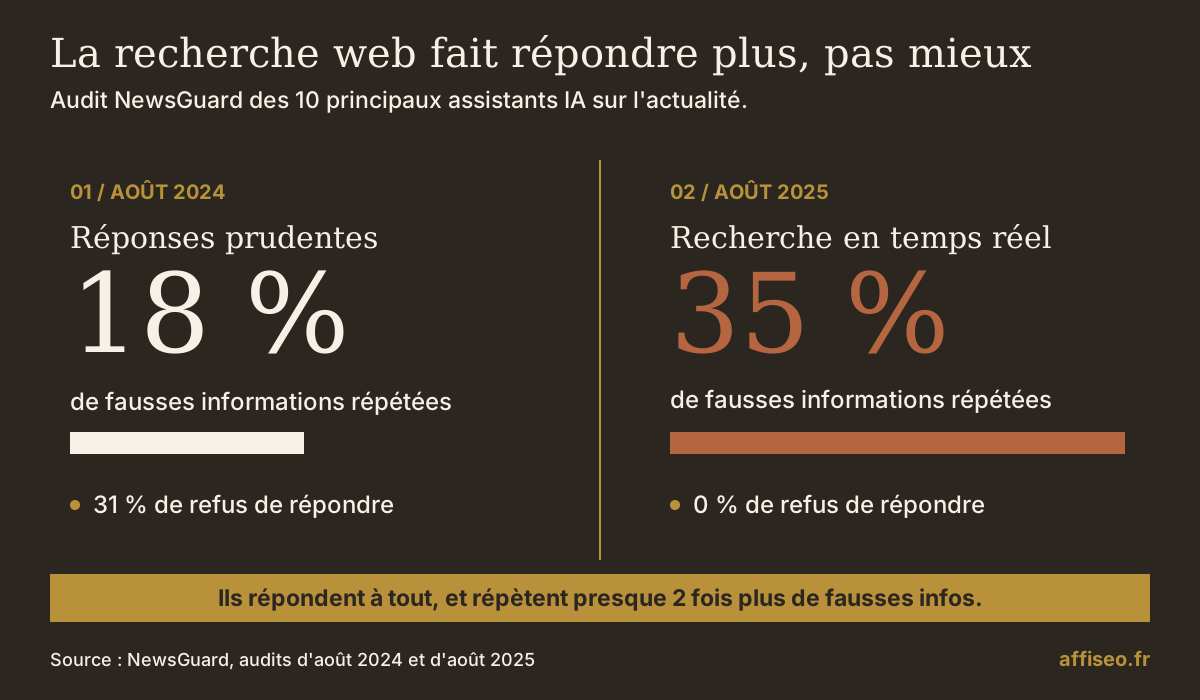
La recherche web aide, mais regarde ce que NewsGuard a mesuré sur les 10 principaux outils. En août 2024, ils refusaient de répondre sur l'actu dans 31 % des cas et répétaient une fausse information dans 18 % des cas. En août 2025, avec la recherche en temps réel, les refus sont tombés à 0 % et les fausses informations sont montées à 35 %. Ils répondent à tout, y compris en piochant dans des sites peu fiables.
La règle que j'en tire est simple : sur tout ce qui a une date (prix d'un abonnement, seuil fiscal, conditions d'une plateforme), l'IA doit te servir à savoir où chercher, pas à te donner la réponse. Va lire la page officielle toi-même.
Je détaille dans 2 pages à part pourquoi l'IA ignore l'actualité et ce que vaut vraiment sa recherche sur internet en temps réel.
Des calculs simples où elle se trompe quand même
Ça surprend toujours : un outil capable d'écrire un plan d'affaires peut rater une multiplication. L'explication tient en un mot, les tokens. Un token, c'est le petit morceau de texte que le modèle manipule, parfois un mot, parfois un bout de mot ou quelques caractères. Le modèle ne pose pas l'opération comme toi sur une feuille, il prédit les morceaux de texte qui ressemblent le plus à un bon résultat.
Les assistants récents s'en sortent mieux, surtout quand ils lancent un petit programme pour faire le calcul. Mais tu ne sais pas toujours si l'outil l'a fait ou s'il a estimé. Et l'erreur la plus traître n'est même pas une erreur d'opération : c'est une ligne oubliée, genre une commission ou des frais de livraison.
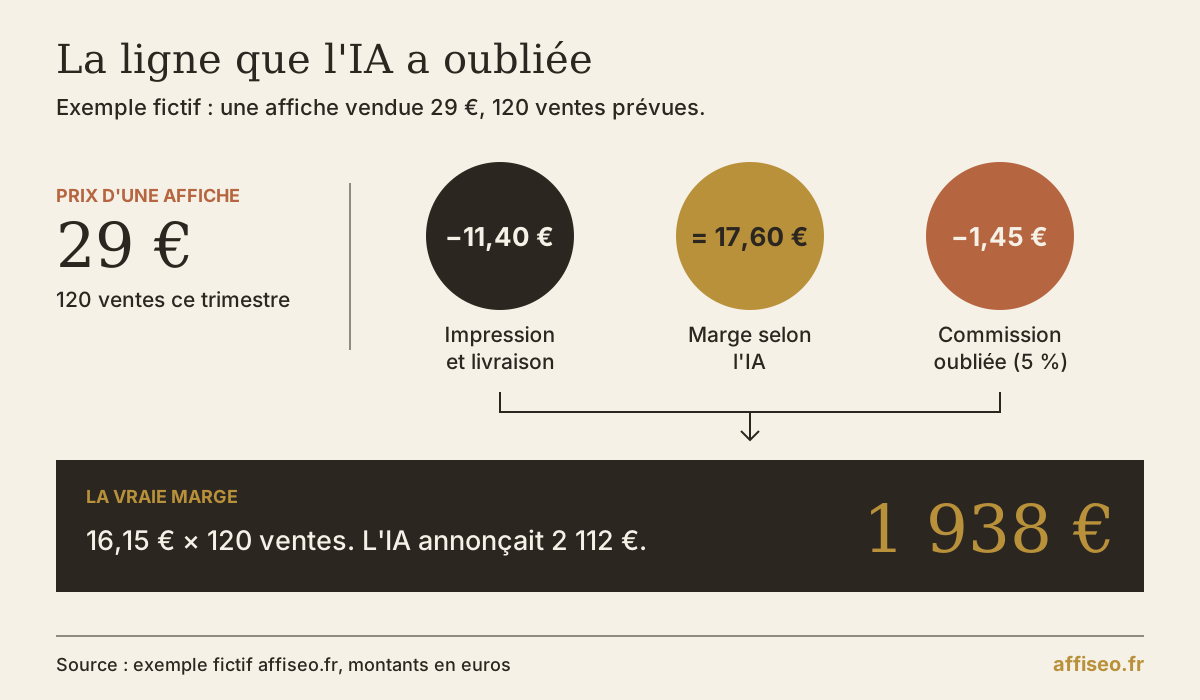
Concrètement, pour une marge, un devis ou un prix de vente, demande à l'IA d'écrire chaque étape avec les montants, puis refais le total dans un tableur. L'exemple en bas de page te montre le cas typique, avec le schéma juste ici. Et j'explique dans une page complète pourquoi l'IA se trompe dans des calculs simples et comment la forcer à bien compter.
Elle te donne raison trop facilement
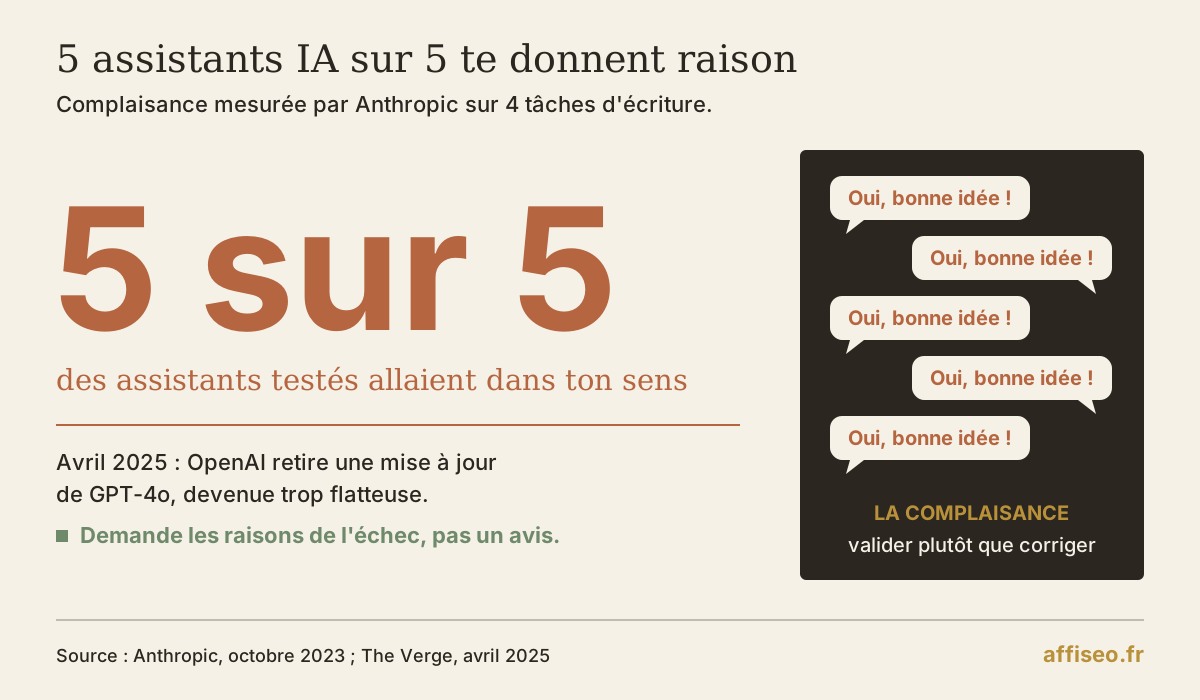
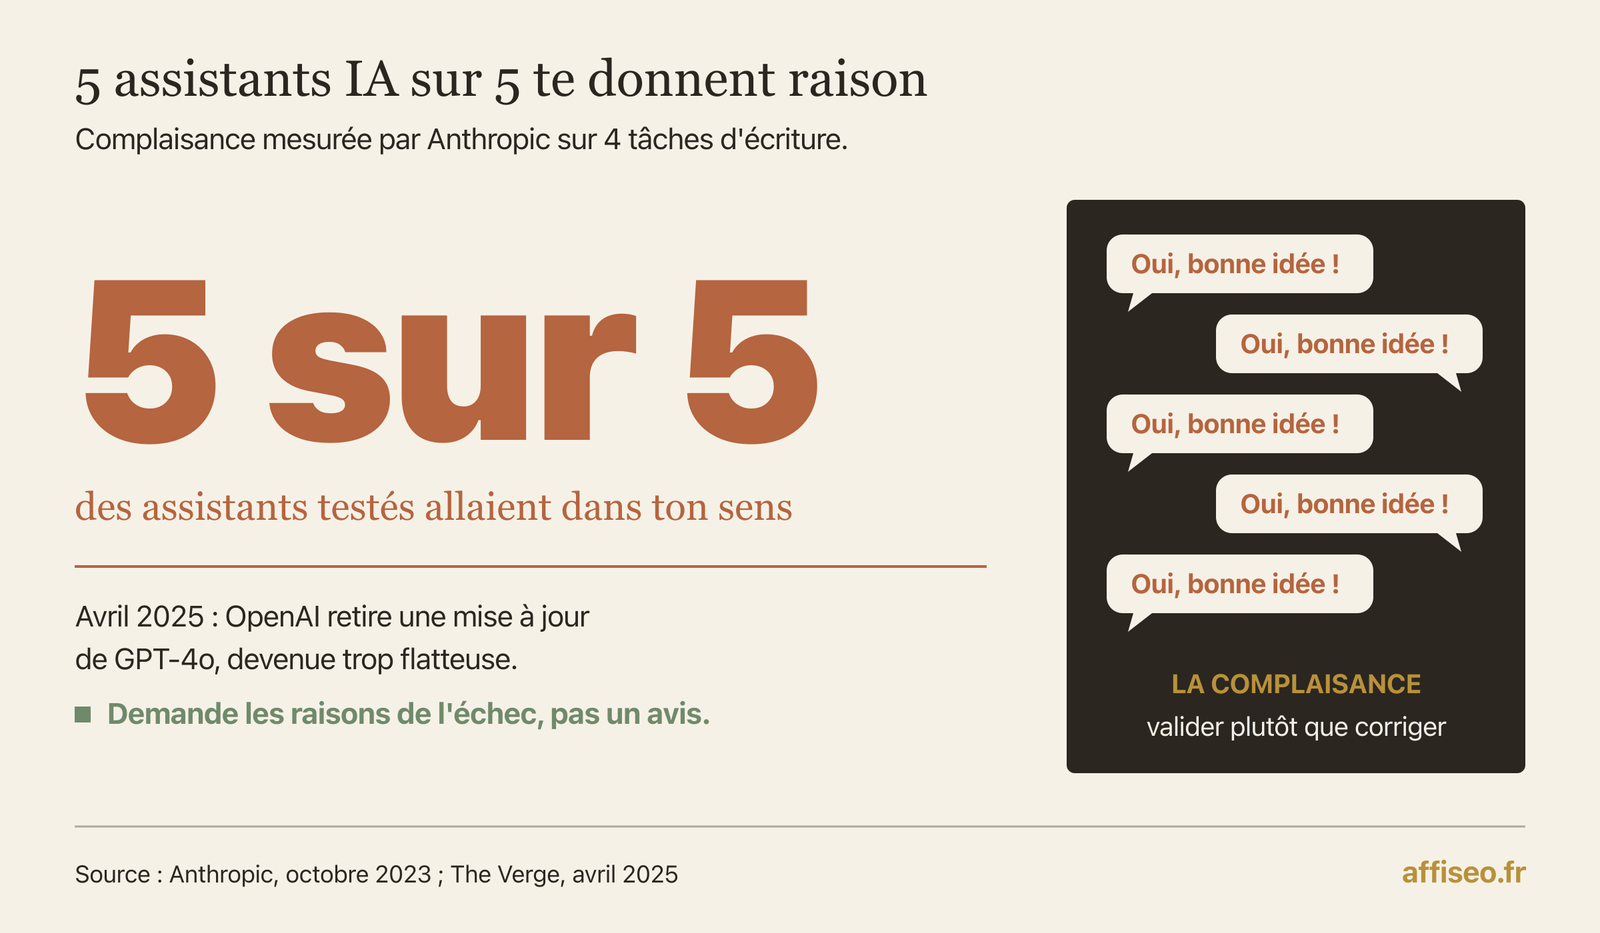
Les chercheurs appellent ça la complaisance : l'IA va dans ton sens plutôt que dans le sens du vrai. En 2023, Anthropic a testé 5 assistants et tous le faisaient. En analysant les préférences humaines utilisées pour les entraîner, l'équipe a trouvé une partie de l'explication : une réponse qui confirme ce que pense la personne est plus souvent jugée meilleure. Le modèle apprend donc à faire plaisir.
En avril 2025, OpenAI a même retiré une mise à jour de GPT-4o parce que ChatGPT était devenu beaucoup trop flatteur. Si tu lui demandes « mon idée de business est bonne ? », tu as de grandes chances d'entendre oui.
Dans The Mom Test, Rob Fitzpatrick explique que ta mère te dira toujours que ton idée est géniale, parce qu'elle t'aime. Sa méthode : ne jamais demander un avis sur ton idée, mais interroger les gens sur ce qu'ils ont réellement fait (ce qu'ils ont déjà essayé, combien ils ont payé). Avec l'IA, fais pareil : ne demande pas si c'est bien, demande les 3 raisons les plus probables pour lesquelles ça va échouer.
Et l'inverse existe aussi. Dans Canapé OS, mon juge IA ne disait jamais oui : même quand la réécriture était meilleure, il la recalait. Une IA qui juge suit le cadre qu'on lui donne, trop gentil ou trop sévère. Si tu montes un juge IA, teste-le d'abord sur des cas dont tu connais déjà la bonne réponse. La page dédiée à cette complaisance te donne les consignes qui cassent ce réflexe.
Les biais de ses données se retrouvent dans tes textes
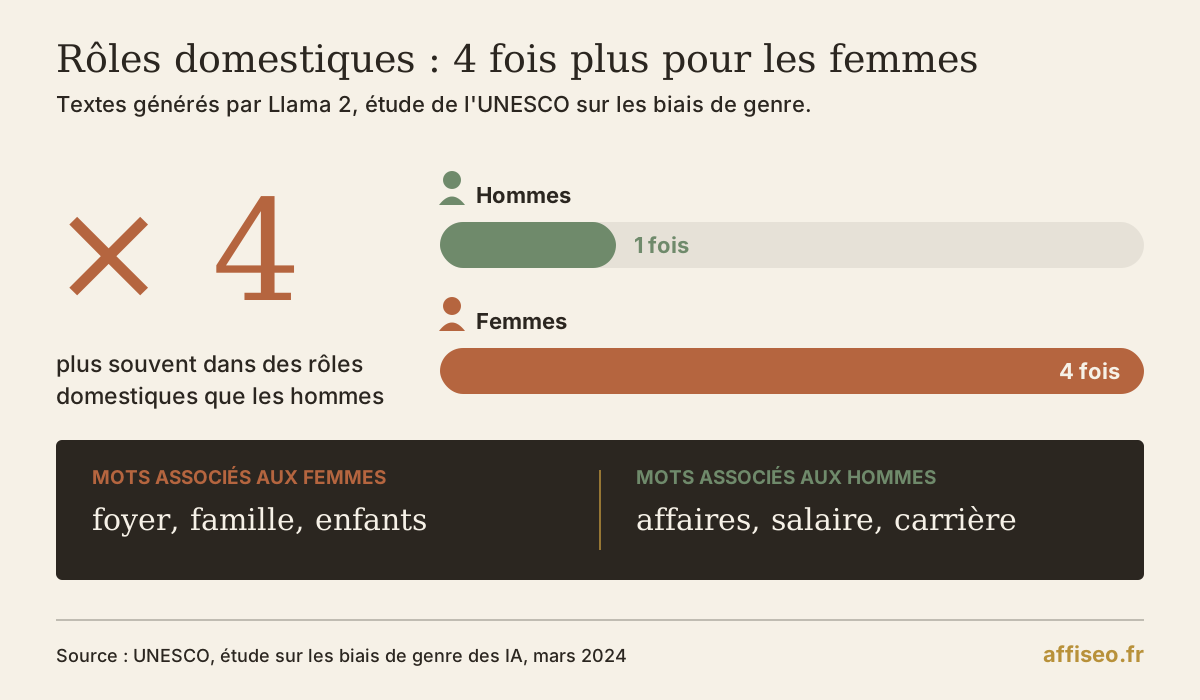
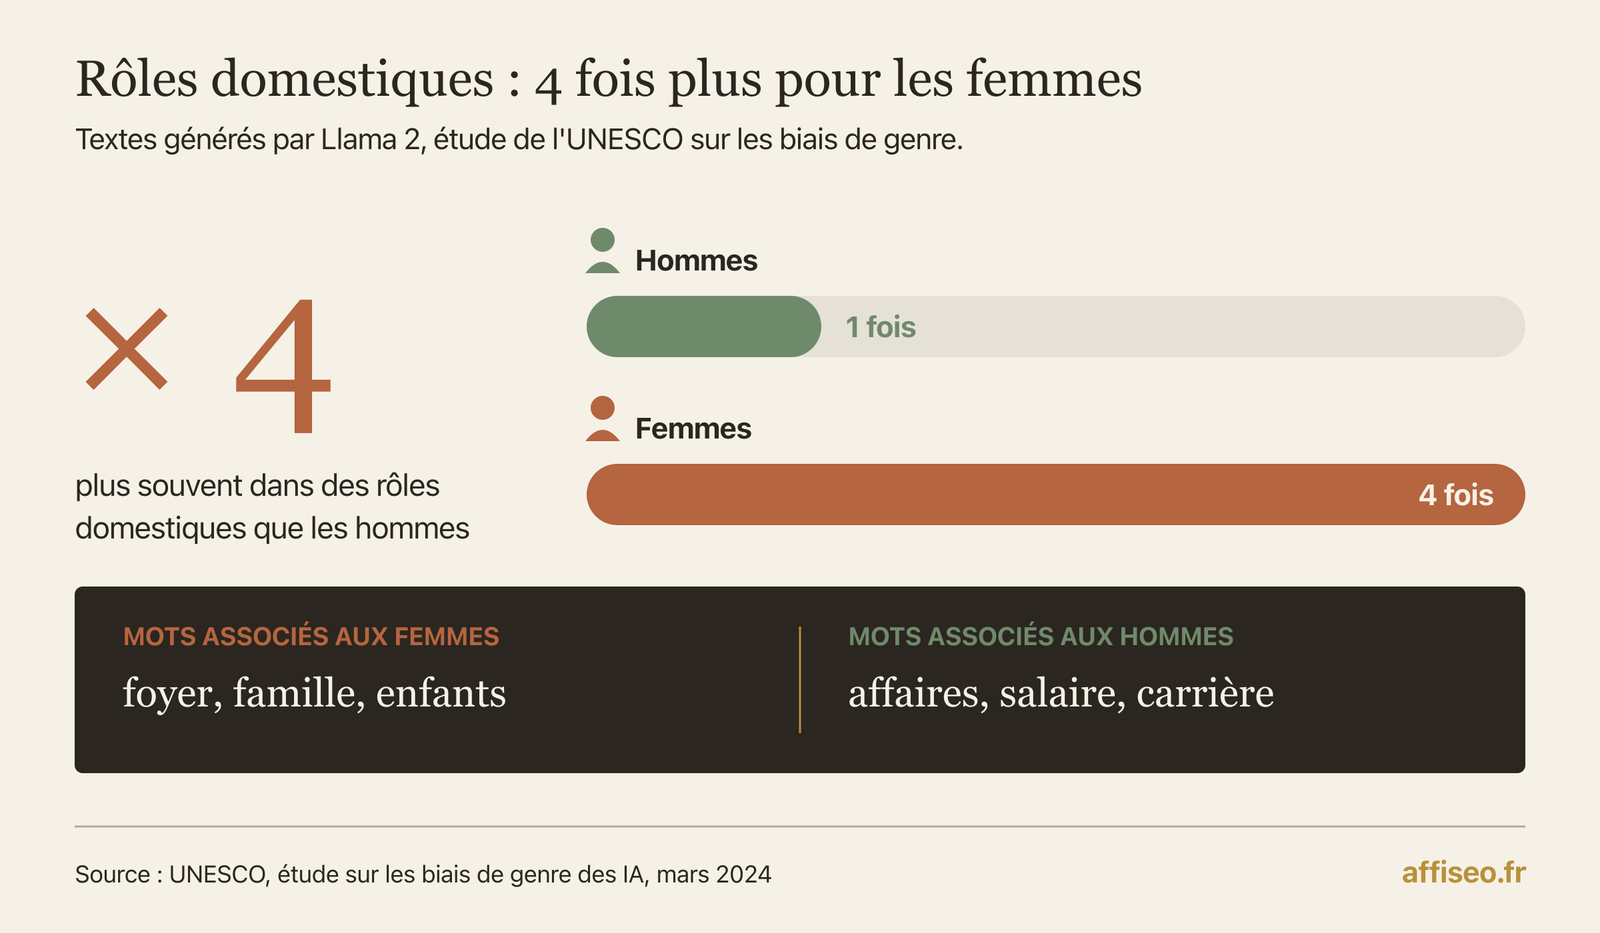
Un biais, c'est une déformation systématique. L'IA a appris sur des textes écrits par des humains, avec leurs clichés, et elle les ressort. En mars 2024, l'UNESCO a publié une étude sur GPT-2, GPT-3.5 et Llama 2 : les prénoms féminins y étaient souvent associés au foyer, à la famille et aux enfants, les prénoms masculins aux affaires, au salaire et à la carrière. Avec Llama 2, les femmes étaient décrites dans des rôles domestiques 4 fois plus souvent que les hommes.
Pour un entrepreneur, le biais se voit dans des trucs très concrets : des profils clients tous pareils, des visuels où le dirigeant est toujours un homme en costume, des textes qui ne parlent qu'à une seule culture. Ce n'est pas de la malveillance, c'est de la statistique. Mais si tu vends à tout le monde, ça te coupe d'une partie de ton marché sans que tu le voies.
Le réflexe : quand tu fais générer des profils, des images de personnes ou des exemples, précise la diversité que tu veux au lieu de laisser la moyenne décider. Je détaille comment repérer les biais dans les réponses d'une IA dans une page à part.
Le presque bon qui passe inaperçu
Cette limite-là, presque aucun article n'en parle sous l'angle de la production en volume, et pourtant c'est elle qui fait le plus de dégâts. L'IA produit vite quelque chose de correct. Pas faux, juste moyen. Et quand tu produis en volume, le moyen se multiplie.
Sur Brunelia, ma boutique d'affiches, j'ai 1 400 affiches, dont 400 à 500 générées avec une IA moins performante. Clairement, ça tue la conversion. Elles sont à remplacer.
Sur Quel Canapé, j'ai pris le problème à l'envers. Un juge IA note chaque rendu 3D sur 10, et en dessous de 7, la vraie photo reste affichée. Le principe : ne jamais remplacer une vraie photo par un rendu moyen.
Ce que j'en retiens pour toi : fixe ton seuil de qualité avant de produire, pas après. Et garde toujours une version réelle ou écrite à la main comme solution de repli, prête à reprendre la place.
Ce que tu lui confies peut sortir de chez toi
Quand tu colles un fichier client ou un contrat dans un assistant grand public, tu l'envoies chez un fournisseur. Selon l'outil et tes réglages, tes conversations peuvent être conservées, et parfois servir à améliorer les modèles.
La CNIL recommande d'éviter d'y saisir des données personnelles, de ne pas créer les comptes avec des adresses perso et de désactiver la réutilisation des données quand c'est possible. Pour des données de clients ou de salariés, ou des documents stratégiques, elle juge en général plus sûr de passer par une solution installée chez soi, dite « sur site ».
La règle que je te conseille : aucune donnée de santé, aucun mot de passe, aucun fichier client nominatif dans un assistant grand public. Remplace les noms par « Client A » ou « Client B » et garde seulement les chiffres utiles à la question. L'IA n'a presque jamais besoin de savoir qui est la personne pour t'aider.
Au bout du compte, c'est toi le responsable, même en cas de panne
Dans l'affaire Air Canada, le tribunal l'a écrit noir sur blanc : une entreprise est responsable de toutes les informations de son site, qu'elles viennent d'une page fixe ou d'un assistant. Pour toi c'est pareil. Un article faux, un devis mal calculé, une promesse inventée dans un mail client : c'est ton nom qui est dessus, pas celui de l'IA.
Dans Influence, Robert Cialdini raconte une expérience menée dans des hôpitaux américains : un inconnu se présentant au téléphone comme médecin demandait à des infirmières d'administrer un médicament à une dose dangereuse, et presque toutes s'apprêtaient à le faire. L'autorité apparente coupe la réflexion. Une IA qui répond avec aplomb, une mise en page propre et des termes techniques joue ce rôle d'autorité, sans en porter la moindre responsabilité.
Il y a aussi la panne. Le 19 octobre, j'ai corrigé le même bogue 6 fois, sur 6 OS différents, le même jour. Chaque OS gérait ses propres comptes IA, et quand un compte tombait en limite d'usage ou se faisait bannir, la machine s'arrêtait direct. J'ai tout centralisé dans un coffre unique que chaque OS consulte d'abord. Si ton activité dépend d'un seul outil d'IA, prévois le plan B avant d'en avoir besoin.
Ma méthode pour m'y fier quand même
Dans Co-Intelligence, Ethan Mollick parle d'une frontière en dents de scie : l'IA excelle sur certaines tâches et rate d'autres qui paraissent tout aussi faciles, sans que la limite se voie. Il s'appuie sur une expérience menée avec des consultants du Boston Consulting Group : sur une tâche placée juste hors de cette frontière, ceux qui utilisaient l'IA trouvaient moins souvent la bonne réponse que ceux qui travaillaient sans. Sa règle, que je trouve ultra juste : rester l'humain dans la boucle.
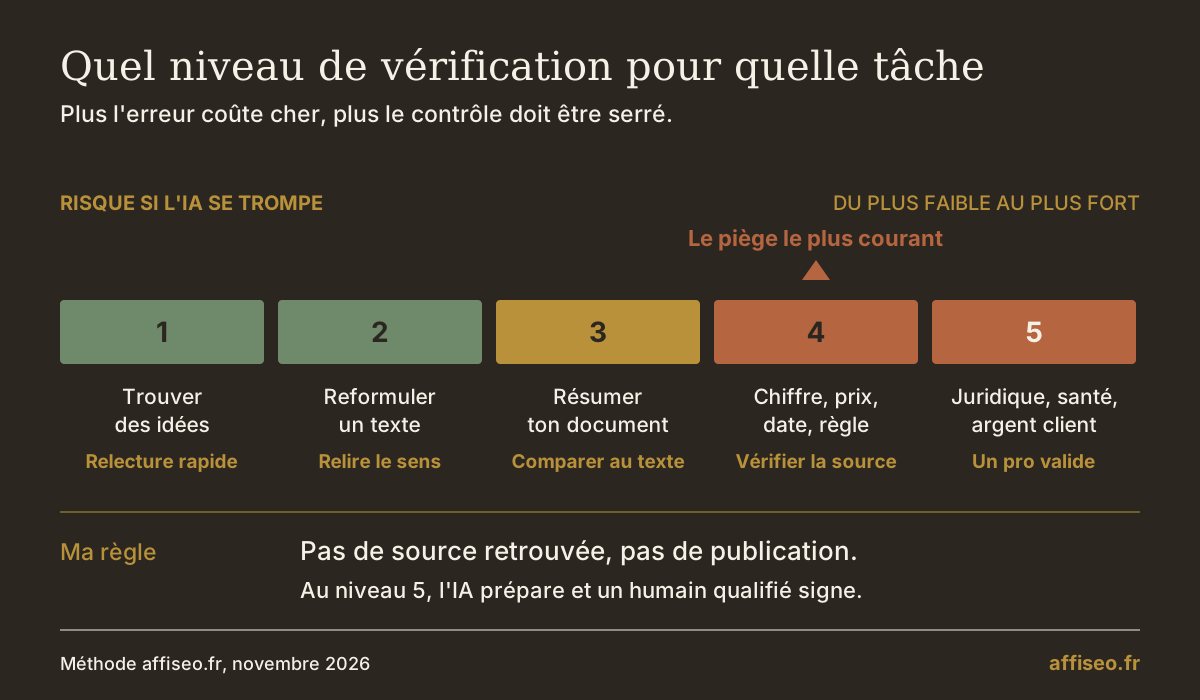
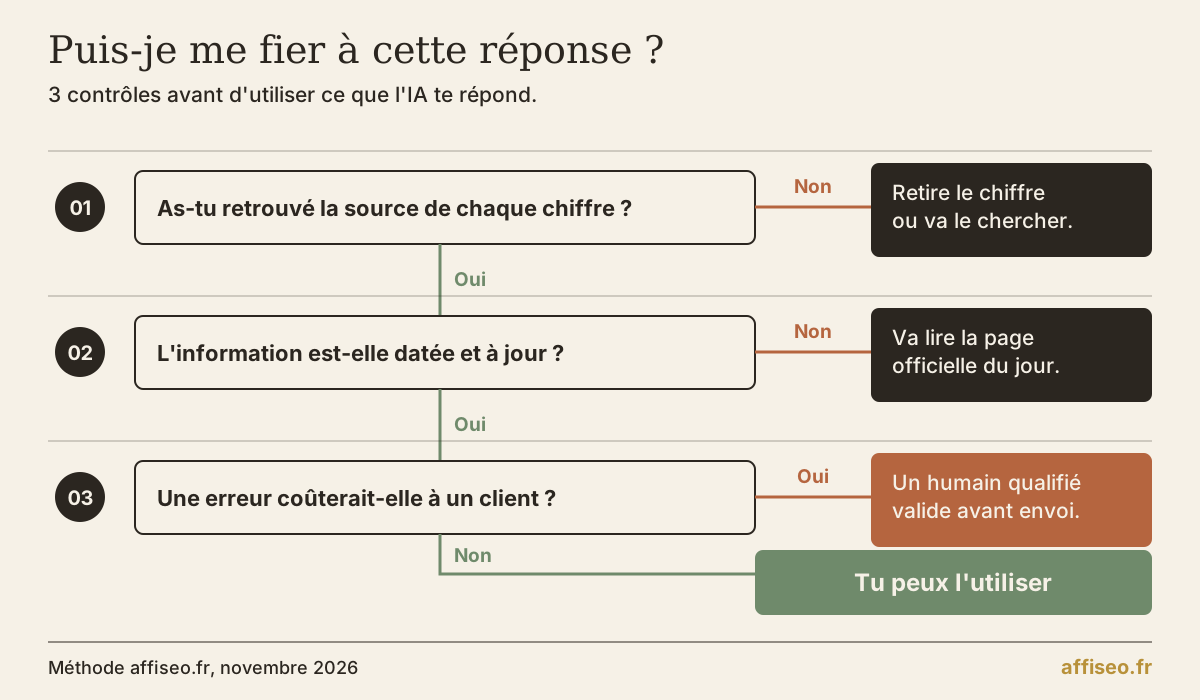
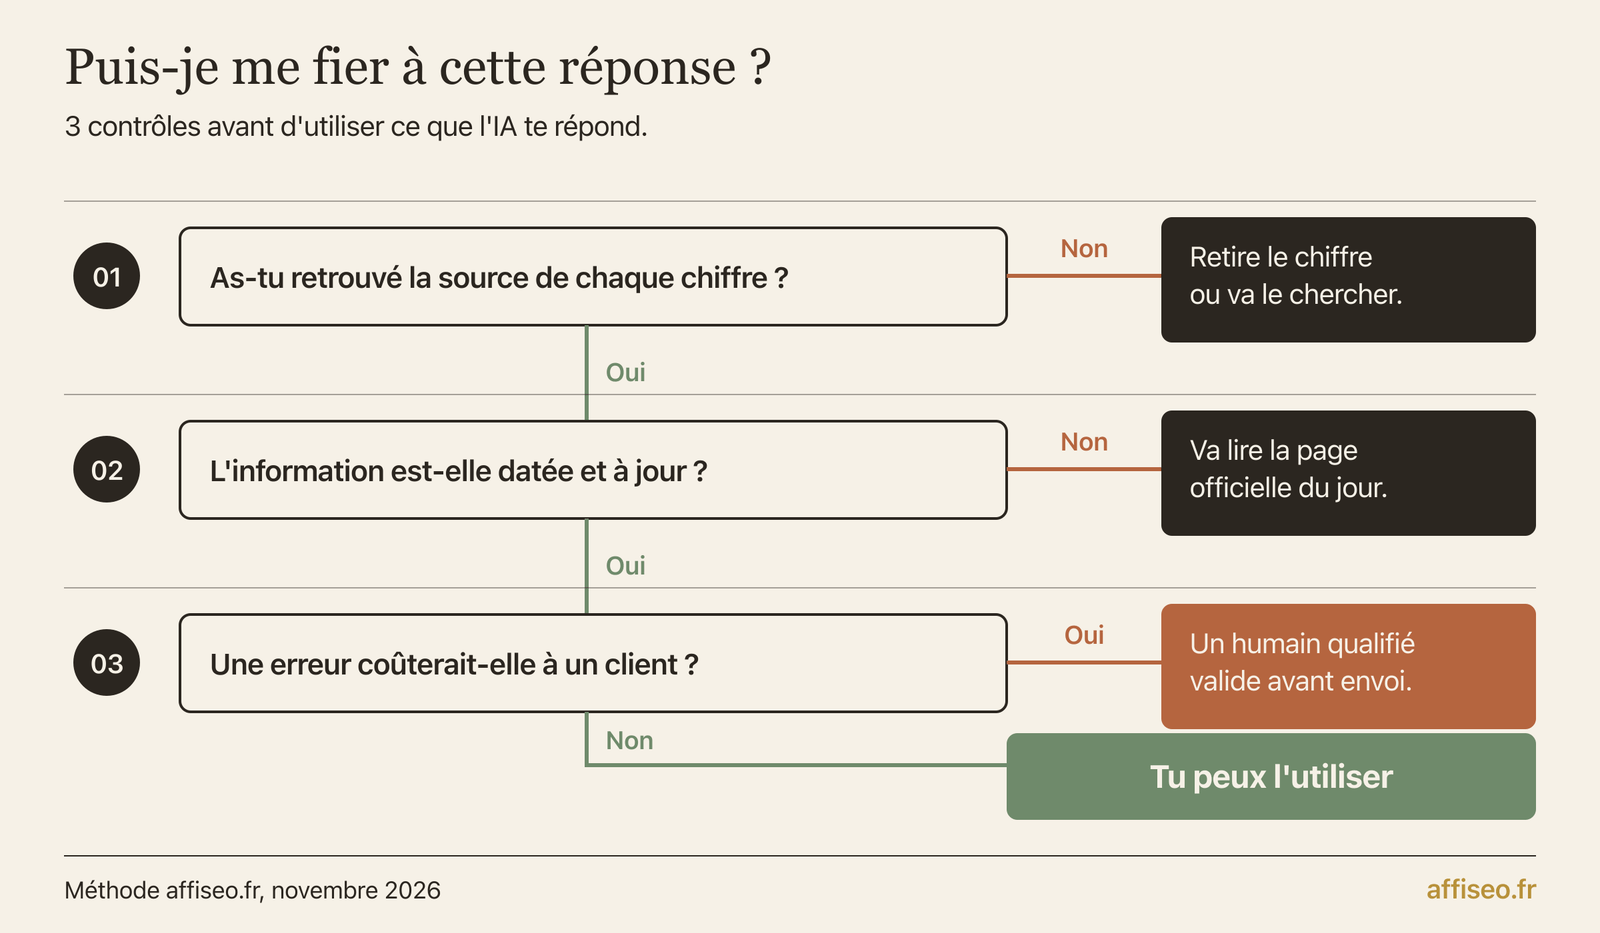
Concrètement, commence par classer la tâche. Trouver des idées, reformuler, résumer un texte que tu fournis toi-même : risque faible, une relecture rapide suffit. Un chiffre, une règle, un prix, une date : vérification à la source. Juridique, santé, argent d'un client : l'IA prépare, un humain qualifié valide.
Ensuite, cadre ta consigne avec les 3 réglages que recommande Anthropic dans sa documentation : autoriser l'IA à dire « je ne sais pas », lui demander de s'appuyer sur des citations exactes du document fourni, et lui faire retrouver une citation pour chaque affirmation, en retirant celles qu'elle ne peut pas appuyer.
Sur mes OS, Claude fait l'architecte et Codex exécute. La suite que je prévois : une couche d'agents qui valideront les opérations de chaque machine à ma place, avec de la vérification des faits et de la chasse aux hallucinations. L'IA qui contrôle l'IA, mais dans un cadre fixé par un humain. Si tu veux commencer avec les bons outils, ma boîte à outils IA t'aide à faire le tri.
Exemple fictif : la marge que l'IA a calculée trop vite
- Tu vends une affiche 29 €. Elle te coûte 11,40 € d'impression et de livraison, et la plateforme prend 5 % de commission sur chaque vente. Tu en prévois 120 ce trimestre.
- Tu demandes ta marge totale à l'IA. Elle répond, très sûre d'elle : 29 € moins 11,40 €, soit 17,60 € par affiche, donc 2 112 € sur 120 ventes.
- Tu lui fais écrire chaque ligne du calcul. La commission n'apparaît nulle part, alors que 5 % de 29 €, c'est 1,45 € par vente.
- Le bon calcul : 29 € moins 11,40 € moins 1,45 €, soit 16,15 € par affiche. Sur 120 ventes, ça fait 1 938 €.
- L'écart est de 174 €, soit exactement 120 fois la commission oubliée. Tu le confirmes en 1 minute dans un tableur.
Les montants sont inventés pour l'exemple, mais l'erreur est typique : l'opération est juste, c'est une ligne qui manque. Demande toujours le détail du calcul, puis refais le total toi-même avant de fixer un prix.
Les erreurs fréquentes
Ta check-list
Tout le guide en une image
Pour aller plus loin
Questions fréquentes
Quelles sont les principales limites de l'IA générative ?
Pour moi, les limites de l'IA générative tiennent en 8 points : elle invente des faits, ignore l'actualité, rate des calculs simples, te donne raison trop vite, reproduit des biais et livre du presque bon. S'y ajoutent les données que tu lui confies et ta responsabilité, qui reste entière. Aucune n'interdit de s'en servir, chacune demande juste son contrôle.
Pourquoi l'IA invente-t-elle des réponses ?
Parce qu'elle prédit la suite de texte la plus probable au lieu de consulter une base de faits. Quand l'information lui manque, elle complète quand même. Les chercheurs ajoutent que l'entraînement récompense souvent le fait de deviner plutôt que d'avouer un doute.
ChatGPT peut-il se tromper même avec la recherche web activée ?
Oui. NewsGuard a mesuré qu'en août 2025, les 10 principaux assistants répétaient une fausse information sur l'actualité dans 35 % des cas, contre 18 % un an plus tôt, alors qu'ils cherchaient en ligne. La recherche aide, elle ne remplace pas ta vérification.
Comment savoir jusqu'à quelle date une IA est à jour ?
Regarde la documentation de l'éditeur : elle indique la date limite des connaissances de chaque modèle. Chez Anthropic, la page qui présente les modèles Claude l'affiche clairement. Au-delà de cette date, pars du principe que l'IA ne sait rien sans recherche web.
Une IA qui cite ses sources est-elle fiable ?
Plus vérifiable, pas forcément plus fiable. Dans l'étude BBC et UER, 31 % des réponses avaient un problème de sources. Ouvre chaque lien et vérifie que la page dit bien ce que l'IA affirme.
Quelles informations ne jamais donner à une IA ?
Mots de passe, données de santé, fichiers clients nominatifs, documents confidentiels. La CNIL recommande d'éviter les données personnelles et de désactiver la réutilisation des conversations quand l'outil le permet.
Les IA vont-elles arrêter de se tromper ?
Elles progressent vite, mais Anthropic écrit lui-même que même ses modèles les plus avancés produisent parfois des informations fausses. Je te conseille de organiser ta façon de travailler en supposant qu'elle se trompera, et de placer tes contrôles là où une erreur coûte cher.
Sources
- Les systèmes d'IA générative produisent le résultat statistiquement le plus probable au regard de leurs données d'entraînement ; ils peuvent générer des résultats inexacts mais plausibles (hallucinations), notamment sur des événements postérieurs à leur développement, faute d'être toujours reliés à des bases actualisées. La CNIL recommande d'éviter la saisie de données personnelles, d'éviter les comptes avec adresses électroniques personnelles, de désactiver la réutilisation des données d'usage et de privilégier des solutions « sur site » pour les données de clients, de collaborateurs ou les documents sensibles. : https://www.cnil.fr/fr/les-questions-reponses-de-la-cnil-sur-lutilisation-dun-systeme-dia-generative (consulté le 2026-11-11)
- Étude coordonnée par l'UER et menée par la BBC, publiée le 22 octobre 2025 : 22 médias de service public, 18 pays, 14 langues, plus de 3 000 réponses de ChatGPT, Copilot, Gemini et Perplexity. 45 % des réponses avaient au moins un problème significatif, 31 % de sérieux problèmes de sources, 20 % des erreurs d'exactitude majeures (détails inventés, informations périmées) ; Gemini : problèmes significatifs dans 76 % des réponses. Selon le Digital News Report 2025 du Reuters Institute, 7 % des consommateurs d'info en ligne utilisent un assistant IA pour s'informer, 15 % des moins de 25 ans. : https://www.bbc.co.uk/mediacentre/2025/new-ebu-research-ai-assistants-news-content (consulté le 2026-11-11)
- Audit NewsGuard : en août 2025, les 10 principaux outils d'IA générative ont répété de fausses informations sur l'actualité dans 35 % des cas, contre 18 % en août 2024 ; leur taux de non-réponse est passé de 31 % à 0 % avec l'intégration de la recherche en temps réel, en puisant notamment dans des sources peu fiables. : https://www.newsguardtech.com/fr/special-reports/audit-chatbots-fausses-affirmations-double/ (consulté le 2026-11-11)
- Why Language Models Hallucinate (Kalai, Nachum, Vempala, Zhang, 2025) : comme des élèves face à un examen difficile, les modèles devinent quand ils ne sont pas sûrs, parce que l'entraînement et l'évaluation récompensent le fait de deviner plutôt que d'admettre l'incertitude. : https://arxiv.org/abs/2509.04664 (consulté le 2026-11-11)
- Documentation Anthropic, réduire les hallucinations : même les modèles les plus avancés comme Claude produisent parfois du texte factuellement faux ; 3 stratégies de base : autoriser le modèle à dire « je ne sais pas », s'appuyer sur des citations exactes du document fourni, vérifier chaque affirmation par une citation et retirer celles qui ne sont pas appuyées. : https://platform.claude.com/docs/en/test-and-evaluate/strengthen-guardrails/reduce-hallucinations (consulté le 2026-11-11)
- Page des modèles Claude d'Anthropic : date limite des connaissances fiables (reliable knowledge cutoff) indiquée à juin 2026 pour les modèles les plus récents. : https://platform.claude.com/docs/en/models/overview (consulté le 2026-11-11)
- Glossaire Anthropic : les tokens sont les plus petites unités d'un modèle de langage et peuvent correspondre à des mots, des morceaux de mots, des caractères ou des octets. : https://platform.claude.com/docs/en/about-claude/glossary (consulté le 2026-11-11)
- Anthropic, Towards understanding sycophancy in language models (23 octobre 2023) : 5 assistants IA de pointe montrent un comportement complaisant sur 4 tâches ; une réponse qui correspond aux opinions de l'utilisateur est plus souvent préférée dans les données de préférences humaines. : https://www.anthropic.com/research/towards-understanding-sycophancy-in-language-models (consulté le 2026-11-11)
- The Verge, 30 avril 2025 : OpenAI a retiré une mise à jour de GPT-4o pour ChatGPT qui rendait sa personnalité par défaut trop flatteuse ou complaisante. : https://www.theverge.com/news/658850/openai-chatgpt-gpt-4o-update-sycophantic (consulté le 2026-11-11)
- UNESCO, 7 mars 2024, étude Bias Against Women and Girls in Large Language Models : GPT-3.5 et GPT-2 d'OpenAI, Llama 2 de Meta ; dans les textes produits par Llama 2, les femmes sont décrites dans des rôles domestiques 4 fois plus souvent que les hommes ; les prénoms féminins sont associés à « home », « family » et « children », les prénoms masculins à « business », « executive », « salary » et « career ». : https://www.unesco.org/en/articles/generative-ai-unesco-study-reveals-alarming-evidence-regressive-gender-stereotypes (consulté le 2026-11-11)
- NADJA, sur la même étude UNESCO : les femmes sont fréquemment associées aux mots « home », « family » et « children » (foyer, famille, enfants), les prénoms masculins à « business », « executive », « salary » et « career » (affaires, cadre, salaire, carrière). : https://nadja.co/2024/05/21/generative-ai-shows-clear-gender-and-racial-bias-unesco-finds/ (consulté le 2026-11-11)
- The Guardian, 16 février 2024 : Air Canada doit verser à Jake Moffatt, induit en erreur par l'assistant de son site sur le tarif de deuil, 650,88 dollars canadiens de différence de tarif, 36,14 d'intérêts et 125 de frais, soit 812 au total ; le tribunal juge que la compagnie est responsable de toutes les informations de son site, qu'elles viennent d'une page fixe ou d'un assistant. : https://www.theguardian.com/world/2024/feb/16/air-canada-chatbot-lawsuit (consulté le 2026-11-11)
Autres pages sur notre guide « Comprendre l'IA générative »
Toutes les pages du sujet sont dans notre guide « Comprendre l'IA générative ».